BLOG
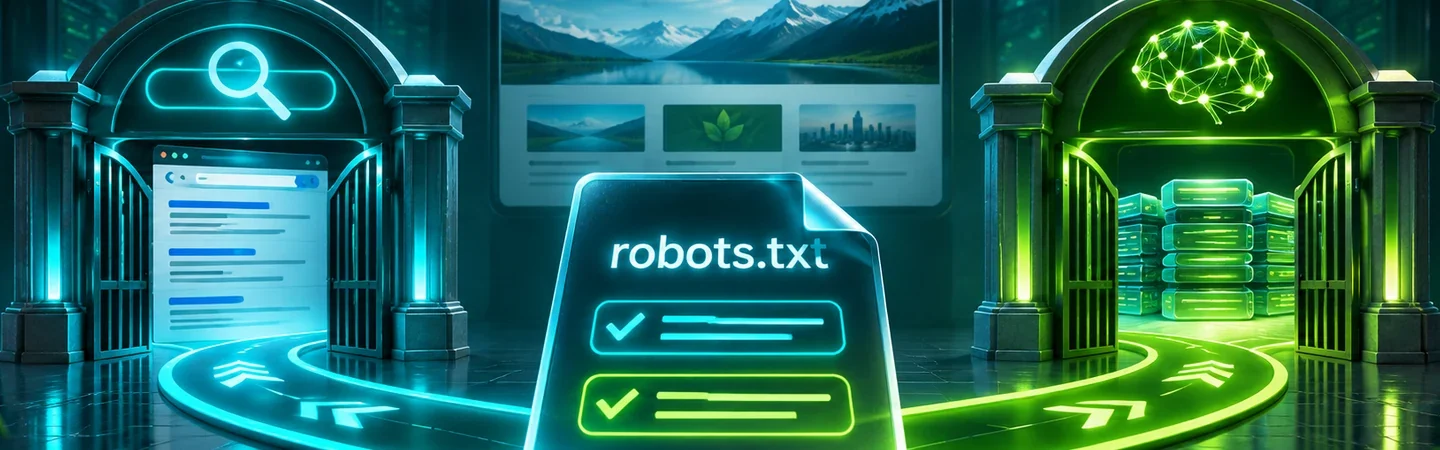
Uma regra de robots.txt pode afetar a presença de um site em mecanismos que usam rastreadores, mas não existe um único “robô de IA”. O Googlebot participa da Busca do Google; a OpenAI documenta o OAI-SearchBot para recursos de busca do ChatGPT e o GPTBot para conteúdo potencialmente usado no treinamento de modelos. Cada finalidade exige uma decisão própria. Antes de copiar um bloco de regras encontrado em um fórum, defina quais páginas devem ser públicas e quais sistemas a empresa quer permitir.
O que o robots.txt faz
O arquivo fica na raiz do host, em um endereço como https://exemplo.com/robots.txt. Rastreadores compatíveis consultam suas diretivas para decidir que caminhos podem visitar. O arquivo não é um controle de acesso para proteger dados privados: qualquer pessoa pode abri-lo, e sistemas maliciosos podem ignorá-lo. Páginas sensíveis precisam de autenticação e configuração adequada no servidor.
Regras de robots controlam rastreamento, não garantem indexação ou exclusão. Uma URL bloqueada pode ser conhecida por links externos mesmo que o robô não consiga ler o conteúdo. Se o objetivo é impedir que uma página pública apareça nos resultados de um mecanismo específico, consulte a documentação de noindex desse mecanismo e confirme que ele pode acessar a página para ler a diretiva. Bloquear o rastreador e esperar que ele leia uma meta tag no HTML é contraditório.
Além do robots.txt, o servidor pode negar acesso por firewall, CDN, proteção contra bots ou regras de autenticação. Uma linha Allow no arquivo não supera um erro 403. Quando há suspeita de bloqueio, compare o arquivo público com logs e resposta real do servidor. Não desative controles de segurança de modo amplo apenas para “liberar IA”.
Googlebot e recursos de IA do Google
O Google orienta proprietários de site a seguir fundamentos de SEO para AI Overviews e AI Mode. Isso inclui permitir rastreamento e indexação das páginas que devem aparecer, oferecer conteúdo útil e manter sinais técnicos coerentes. A documentação de recursos de IA explica como o conteúdo pode participar dessas experiências. Não trate uma diretiva inventada para “Google IA” como substituta da configuração normal da Busca.
Se uma página importante está fora do índice, use a inspeção de URL no Search Console. Verifique o estado que o Google registrou, a URL canônica, possíveis bloqueios e a versão pública atual. Um erro de canonical ou uma página com conteúdo insuficiente não é resolvido apenas ajustando robots. O sitemap ajuda na descoberta, mas não obriga o Google a indexar a URL.
Decisões sobre acesso devem considerar a propriedade correta. robots.txt em um subdomínio não controla automaticamente outro host. Se o blog está em blog.exemplo.com e o site institucional em www.exemplo.com, confira ambos. Migrações e ambientes de teste também exigem cuidado para não copiar regras de bloqueio do staging para produção.
OAI-SearchBot: busca no ChatGPT
A OpenAI descreve o OAI-SearchBot como o agente usado para apresentar sites em recursos de busca do ChatGPT. Se o objetivo é que páginas públicas sejam elegíveis a esses resultados, a orientação oficial é permitir esse agente no robots.txt e aceitar solicitações das faixas de IP publicadas pela empresa. Isso não garante colocação: a busca considera vários fatores para oferecer resultados relevantes e confiáveis.
Verifique se a política da empresa permite a descoberta dessas páginas. Em seguida, examine regras gerais como User-agent: * e regras específicas para o agente. Não cole exemplos sem entender precedência e escopo. Um Disallow: / geral pode ter efeitos mais amplos do que a equipe imagina. Teste URLs importantes, inclusive artigo, página de serviço e imagem principal, conforme a necessidade da plataforma.
Considere o tempo de atualização. A OpenAI informa que seus sistemas podem levar algum tempo para refletir mudanças no robots.txt. Um teste feito minutos após a alteração não permite concluir que a decisão foi ignorada. Registre data, arquivo anterior, nova regra e URLs de teste. Se ainda há erro, verifique CDN e logs antes de editar novamente.
GPTBot: uma finalidade diferente
O GPTBot é documentado pela OpenAI para rastrear conteúdo que pode ser usado no treinamento de modelos. A empresa diz que a escolha de permitir OAI-SearchBot e bloquear GPTBot pode ser feita separadamente. Isso permite formular uma política sem confundir busca com treinamento. A decisão deve refletir preferências do proprietário do conteúdo e acordos aplicáveis, não a promessa de ganho de ranking.
Bloquear GPTBot não significa bloquear automaticamente a aparição em ChatGPT Search, desde que o agente de busca continue autorizado e não haja outras barreiras. Da mesma forma, permitir GPTBot não garante presença em respostas. Trate as duas regras como controles de finalidade distintos. Revise a documentação oficial quando for alterar a política, porque nomes e comportamentos podem evoluir.
Outros agentes também existem, inclusive acessos iniciados por usuários. A documentação da OpenAI diferencia ChatGPT-User de rastreamento automático para busca. Não reduza toda solicitação de IA a um único nome de user-agent. Ao analisar logs, observe agente, IP, URL, data e resposta do servidor, sabendo que user-agent pode ser falsificado. Para checagem técnica, use as faixas oficiais publicadas pelo fornecedor.
Como auditar o arquivo em WordPress
Primeiro, abra a URL pública do robots em uma janela anônima. Alguns sites servem um arquivo físico; outros geram um robots virtual. O que vale para o rastreador é a resposta pública, não a tela do plugin. Salve uma cópia antes de mudar. Verifique se há regras duplicadas, caminhos com erro de digitação e bloqueios herdados de migrações.
Segundo, liste as URLs que devem ser acessíveis. Inclua home, páginas de serviço, artigos e recursos essenciais. Compare o caminho real de cada URL com as regras. Um bloqueio amplo de /wp-content/ pode afetar imagens e outros arquivos necessários para renderização, dependendo da implementação. Não assuma que todo diretório de WordPress é privado; também não libere /wp-admin/ só para satisfazer uma ferramenta.
Terceiro, confira resposta HTTP dessas URLs para um visitante anônimo e, quando houver acesso legítimo aos logs, para o rastreador de interesse. Um teste com curl usando apenas o nome do agente pode ajudar a reproduzir configuração superficial, mas não prova acesso real se o firewall valida IP. Para um diagnóstico confiável, observe solicitações verificadas ou use ferramentas oficiais de inspeção quando disponíveis.
Quarto, inspecione a página em si. noindex, canonical, redirecionamentos e conteúdo renderizado podem impedir ou alterar a visibilidade mesmo com rastreamento permitido. A auditoria de robots é uma parte do diagnóstico, não o diagnóstico inteiro. Depois de mudar o arquivo, teste novamente URLs importantes e registre o resultado.
Exemplo de política, sem copiar cegamente
Uma empresa pode querer que seu conteúdo público seja considerado na Busca Google e em ChatGPT Search, mas optar por não disponibilizá-lo ao treinamento do GPTBot. A política técnica correspondente precisa ser escrita com base nas regras atuais de cada serviço e no robots.txt existente. Antes de aplicar, confira se não há um bloco geral que conflita, se o arquivo vale para o host certo e se CDN ou servidor respeitam a intenção.
Não publique uma receita pronta de três linhas como solução universal. Em um site com áreas de cliente, staging, loja e blog em hosts diferentes, a mesma regra teria resultados distintos. Documente a intenção em linguagem de negócio: quais seções são públicas, qual busca é desejada e qual uso de treinamento é permitido. Só depois traduza isso em diretivas e testes.
Como medir o resultado da mudança
Uma alteração de robots deve ser verificada primeiro por acesso: o arquivo público mostra a regra nova? As URLs permitidas respondem? Logs indicam solicitações aceitas em vez de 403? Depois acompanhe descoberta e desempenho nas ferramentas do mecanismo correspondente. Não interprete ausência de citações logo após a mudança como prova de falha, nem uma citação isolada como prova de causalidade.
No Google, acompanhe indexação e desempenho no Search Console. Para ChatGPT Search, observe referências identificáveis e testes manuais documentados com perguntas pertinentes. Mantenha resultados separados: acesso técnico, exposição em resposta, clique e contato. Essa cadeia torna claro o que a configuração conseguiu e o que continua dependendo da qualidade do conteúdo e da relevância da pergunta.
Perguntas frequentes
A CDN permite o robô no robots.txt, mas devolve 403. O que verificar?
Confira no log a URL, a data, o IP de origem e a regra de segurança que negou a solicitação. Compare o IP com a lista publicada pelo fornecedor do rastreador; um nome de agente sozinho pode ser falsificado. Ajuste apenas a regra que afeta as páginas públicas desejadas e teste de novo. Não desligue toda a proteção contra bots para resolver uma única negação.
O WordPress mostra um robots.txt diferente do arquivo que editei. Qual vale?
Vale a resposta pública em https://seu-dominio/robots.txt. O WordPress pode gerar esse conteúdo virtualmente, enquanto hospedagem, cache ou um arquivo físico podem entregar outra versão. Abra o endereço sem login e confira o conteúdo efetivamente servido antes de concluir que a mudança foi aplicada.
Checklist final
Defina a política de acesso por finalidade. Confira o robots.txt público de cada host. Diferencie Googlebot, OAI-SearchBot, GPTBot e acessos iniciados por usuários. Teste páginas prioritárias, servidor e CDN. Confirme noindex, canonical e resposta HTTP. Registre a configuração antes e depois. Revise a documentação oficial quando os mecanismos mudarem. O objetivo é fazer a política técnica corresponder à decisão editorial da empresa, sem prometer resultados que uma regra de robots não controla.
Fontes
- OpenAI, Overview of OpenAI Crawlers.
- OpenAI, Searching the web with ChatGPT.
- Google Search Central, Recursos de IA e seu site.
- Google Search Central, Interpretação de robots.txt.