BLOG
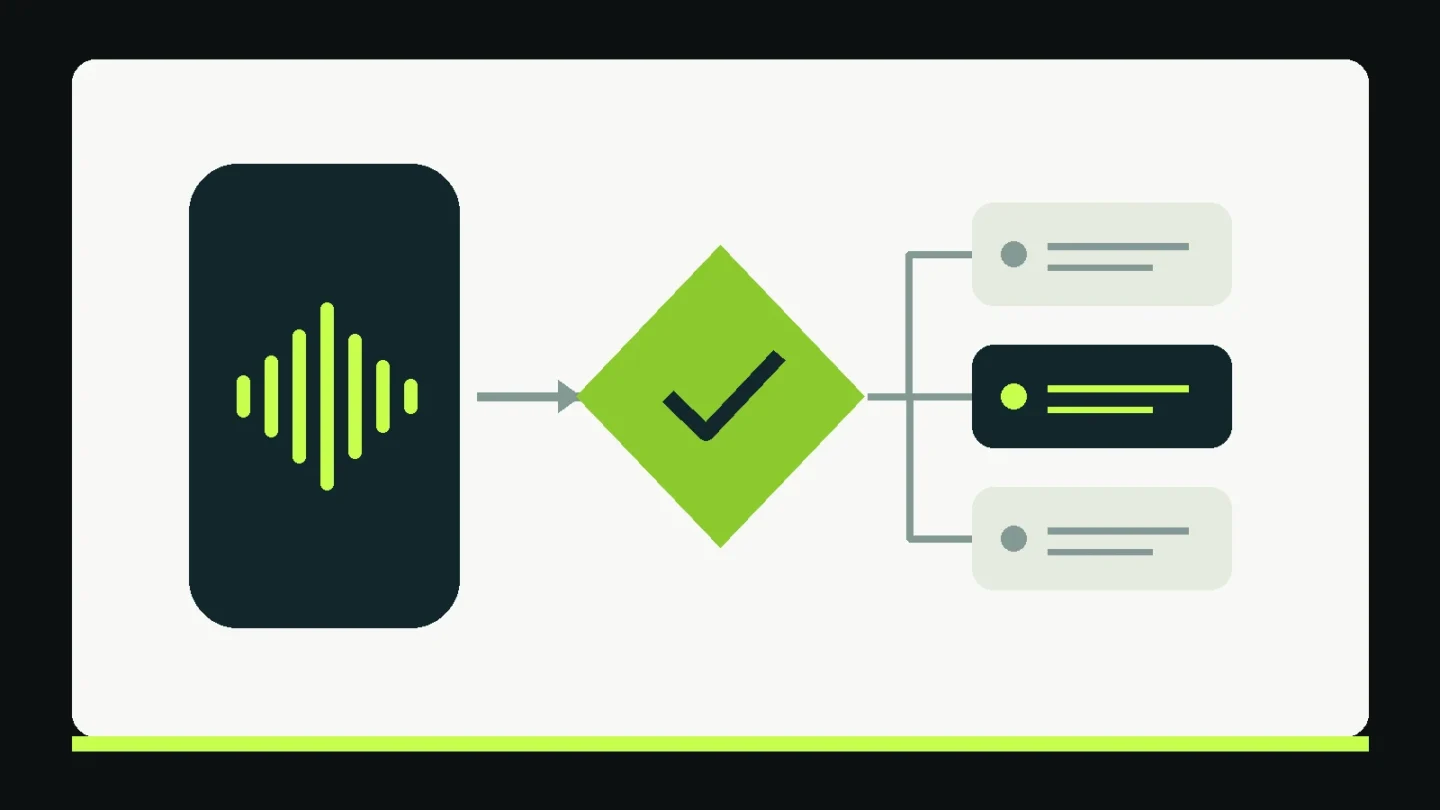
O GPT-Live ganhou integração nativa com a Decisions API em 15 de outubro de 2026. A novidade permite classificar pedidos enquanto a pessoa fala e devolver decisões ao aplicativo. Para quem desenvolve atendimento por voz, abre um caminho mais direto entre conversa e encaminhamento, conforme o changelog oficial da OpenAI.
Orientação prática: comece classificando a intenção e preparando consultas. Exija confirmação antes de alterar um agendamento, enviar uma comunicação ou mudar dados do cliente.
O que mudou no GPT-Live
O GPT-Live já separava a conversa falada do trabalho executado por um backend. A documentação de início explica que o modelo pode ouvir e falar ao mesmo tempo, enquanto outro componente consulta sistemas e realiza tarefas.
A mudança de 15 de outubro está na ligação com Decisions. Na delegação personalizada, o Live avisa seu aplicativo, que chama a API de decisões. Na integração nativa, o próprio serviço faz essa chamada. É uma etapa de comunicação a menos nesse caminho; o tempo total ainda depende do restante da aplicação. O guia de integração por voz também descreve gatilhos ligados aos trechos de transcrição recebidos ou emitidos.
| Parte | Função | Decisão de projeto |
|---|---|---|
| GPT-Live | Conduzir a conversa por voz. | Definir quando esclarecer uma dúvida e quando delegar. |
| Decisions | Retornar uma classificação ou avaliação tipada. | Oferecer opções que o processo realmente sabe tratar. |
| Seu aplicativo | Validar e executar as ações autorizadas. | Conferir permissões, confirmação e resultado no sistema. |
A documentação de delegação e ferramentas mantém permissões, confirmações, registros e estado da tarefa sob responsabilidade da aplicação. Receber uma categoria como “remarcar” ainda exige localizar o compromisso correto e obter a aprovação necessária.
Quem pode usar no Brasil e quais são os requisitos
O Brasil consta na lista de países atendidos pela API. Isso confirma suporte territorial geral, sem demonstrar que um projeto específico já possui todos os acessos exigidos. A Decisions API está em disponibilidade geral desde 22 de outubro de 2026, conforme o changelog oficial, e usa gpt-6-luna, segundo seu guia oficial.
Para a configuração nativa, a documentação pede uma conexão Live funcionando e a permissão api.decisions.write. A delegação é definida ao criar a sessão; o tipo permanece fixo nela. Confira os detalhes no guia técnico, antes de adaptar um projeto existente.
O exemplo inicial para navegador exige microfone, página em HTTPS ou localhost e servidor confiável com a chave do projeto. A chave fica no servidor. Para a operação, reserve também tempo de desenvolvimento para os sistemas que sua empresa precisa consultar e para a passagem a um atendente.
Quanto custa: voz e decisões têm cobranças diferentes
Na página do GPT-Live 1, a sessão de voz custa US$ 0,05 por minuto, com cobrança por segundo. Uso de modelos no backend e ferramentas é cobrado separadamente. Como conta ilustrativa, dez minutos correspondem a US$ 0,50 apenas nessa camada de voz.
No endpoint Decisions com gpt-6-luna, o preço documentado é US$ 0,10 por milhão de tokens de entrada sem cache, sem cobrança por tokens de saída. As gravações de cache são cobradas; as leituras recebem desconto, com as tarifas de cache padrão do gpt-6-luna. Multiplicadores de contexto longo e adicionais regionais podem se aplicar. Essa tarifa não deve ser estendida a qualquer chamada ao Luna.
O catálogo informa que o GPT-Live não atende ao nível Free e limita sessões simultâneas a 50 no Build, 300 no Launch e 500 no Grow. São limites de concorrência, e não uma franquia de minutos. Consulte a tabela do modelo para dimensionar o atendimento.
O planejamento deve separar assinatura do ChatGPT e consumo pela API, como orienta a documentação de preços. Some ainda servidor, integração, monitoramento e eventual provedor de telefonia. Não há custo total por atendimento demonstrado neste artigo.
Exemplo: classificar um pedido sem remarcar por engano
Imagine uma agência que recebe pedidos de reunião por voz. Como proposta editorial, ela poderia trabalhar com quatro intenções: consultar horários, solicitar remarcação, falar com alguém e esclarecer o pedido. A última opção evita obrigar o sistema a escolher uma ação quando faltam informações.
Na frase “Quero trocar a reunião, mas ainda preciso confirmar minha agenda”, reconhecer interesse em remarcação não autoriza modificar o calendário. O aplicativo pode preparar uma consulta e perguntar quais horários servem. A gravação deve esperar a escolha explícita e a confirmação de que a vaga continua disponível.
Se o cliente se corrigir durante a conversa, o projeto precisa reconciliar a intenção mais recente com a tarefa em andamento. Um pedido antigo não deve ser executado só porque chegou primeiro ao sistema. Essa é uma regra de implementação proposta para o cenário, que precisa de teste com as integrações reais.
Em um projeto com n8n, a arquitetura pode manter a sessão de áudio em um serviço próprio e usar fluxos separados para consultar CRM e agenda. Isso exige integração desenvolvida e validada; o anúncio não comprova compatibilidade de um nó pronto do n8n com GPT-Live. Veja também o guia do blog sobre aprovação humana de ações de agentes.
Como avaliar antes de atender clientes
Prepare casos com resultados esperados e registre o que a aplicação realmente fez. Nossa recomendação é começar com consultas sem alteração de registros e ampliar o escopo depois de revisar erros. Para organizar essa avaliação, use o roteiro de como testar um agente de IA antes do atendimento.
- Pedido incompleto: verificar se o agente pergunta o que falta em vez de escolher uma ação arbitrária.
- Correção durante a fala: conferir se a intenção anterior deixa de comandar a tarefa.
- Falha do CRM: exigir uma resposta coerente com o erro, sem anunciar uma alteração inexistente.
- Evento repetido: impedir que a mesma autorização gere duas alterações.
- Transferência para pessoa: conferir se o atendente recebe o pedido e seu estado atual.
Meça tempo até a classificação, tempo até o resultado do sistema, encaminhamentos incorretos e custo completo por sessão. Uma classificação rápida com escolha errada continua prejudicando o atendimento. A OpenAI recomenda que o Live aguarde o resultado do backend antes de confirmar preço, reserva ou conclusão; essa orientação consta no guia de prompting.
Quando vale investigar esta integração
O GPT-Live com Decisions merece um piloto quando o atendimento já tem intenções bem definidas, integrações disponíveis e uma pessoa responsável por revisar falhas. Para um negócio que ainda recebe poucas solicitações e resolve tudo manualmente, organizar o processo e os dados pode trazer mais valor imediato.
O próximo passo é escolher uma consulta simples, definir as respostas permitidas e avaliar conversas representativas. A notícia cria uma opção técnica para aproximar voz e automação; o ganho no seu atendimento depende da implementação e das medições que ainda serão feitas.